Vibecoding et applications auto-hébergées : ces applications ont-elles un endroit où atterrir dans le monde de l'entreprise ?
C’est aujourd’hui la réalité de toute direction informatique. Ne pas être prêt, ne pas avoir de réponses à ces questions et dire à ses utilisateurs « revenez dans un trimestre » les conduira immanquablement à chercher des solutions alternatives, et ouvre grand la voie au shadow IT.
Comment s’assurer que ces applications ne facilitent pas l’exfiltration ou la manipulation de données d’entreprise dans des lieux non fiables ? Comment garantir la pérennité d’applications qui, une fois déployées, sont souvent adoptées massivement et rapidement, et deviennent critiques ? Le laptop d’un utilisateur n’est pas une option. Les services d’hébergement gratuits auxquels les outils d’IA se connectent volontiers non plus.
Une gouvernance est nécessaire, et il est essentiel que l’IT soit prête à l’avance, capable de répondre vite aux besoins des utilisateurs. Sinon, ils trouveront leur propre voie, et ce sera la porte ouverte au shadow IT.
Les attentes sont multipliées par dix
Une production de code intense et facile relève le niveau d’attente des utilisateurs, et pas seulement pour leurs propres prototypes. Le nombre de bonnes applications open source, développées en un temps record et bien maintenues, les tente également (+20% de nouveaux projects sur Github chaque année depuis 2020). Cela les pousse à installer tout ce qu’il faut pour les évaluer, et parfois à les mettre en production, hébergées sur leur propre ordinateur ou sur des plateformes tierces qui ne conviennent pas à un usage professionnel.
Ce faisant, ils échappent complètement à la vigilance de l’IT. Souvent sans savoir ce qu’ils font, ils créent du shadow IT, échappent aux contrôles et standards de sécurité et mettent parfois en jeu les données de l’entreprise et la continuité de son activité.
Cela ne peut plus être remis à plus tard
Des utilisateurs métier, des analystes et des équipes sans développeur arrivent désormais avec quelque chose qui fonctionne déjà, le tout créé avec des assistants IA. Ils ont un vrai besoin et un prototype qui y répond. Ce n’est plus une tendance à surveiller. C’est ce qui franchit la porte du département IT chaque semaine.
La réponse habituelle d’une équipe IT débordée, « revenez dans six mois, nous allons étudier ce qui est faisable et avons besoin de temps pour cela », ne les arrête plus. Elle les envoie ailleurs : un abonnement personnel, un mot de passe partagé, une application que personne à l’IT ne connaît, mal protégée, impossible à auditer, et qui peut laisser des données critiques de l’entreprise échapper à tout contrôle. Mettre les demandes en attente parce que « nous ne sommes pas prêts » est précisément ce qui pousse les gens à chercher leurs propres solutions. Faire l’autruche ne fait pas disparaître le sujet. Cela le rend invisible, et mène tout droit au shadow IT.
Point de départ : trois types d’applications à votre porte
Les applications créées par vibe coding font la une, mais ce n’est qu’une des arrivées. Une porte d’entrée utile traite chaque type selon ce qui peut réellement mal tourner, et selon ce qu’il faut pour l’héberger et le construire en répondant à tous les objectifs associés : sécurité, coût, conformité, flexibilité et facilité de déploiement. Nous en avons identifié trois :
- Les applications open source auto-hébergées. Développées par un projet public que l’organisation ne contrôle pas, mais qu’elle décide d’héberger. C’est la Lane A.
- Les applications internes et créées par vibe coding. Conçues par des développeurs, ou par des utilisateurs métier avec des assistants IA. Elles subissent les mêmes contraintes et portent les mêmes risques, si bien que les contrôles de la porte d’entrée valent pour les unes comme pour les autres. C’est la Lane B.
- Les applications SaaS. Hébergées et exploitées par un éditeur. Elles restent en dehors de cette porte d’entrée, et le schéma explique pourquoi (voir ci-dessous).
Toute application qui passe par la porte d’entrée est affectée à exactement une lane avant tout provisioning.
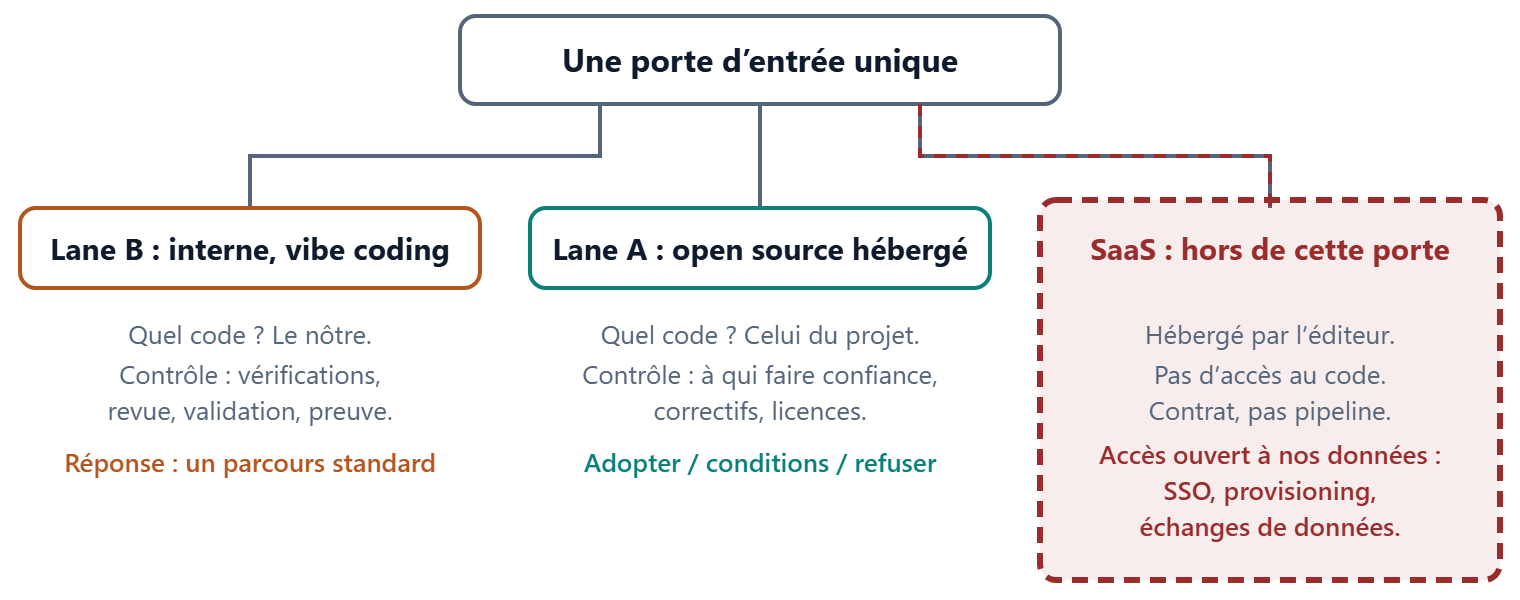
Lane A : vous ne revoyez pas du code, vous choisissez à qui faire confiance. Les questions se déplacent de la source vers la chaîne d’approvisionnement : d’où vient le logiciel, ce que l’on sait déjà de ses défauts, qui le maintient à jour, ce que sa licence vous impose. La réponse est l’une de trois, chacune motivée et documentée : adopter, adopter sous conditions, ou refuser. Les équipes ont droit à une décision claire, y compris un non clair, et à l’obtenir vite.
Lane B : le code est le nôtre, donc les contrôles portent sur ce qu’il devient : vérifications automatiques avant chaque build, une version testée qui devient la version livrée, et validation par les personnes qui répondent de l’application.
SaaS : vous n’avez aucun contrôle au-delà de l’évaluation du fournisseur. Vous vérifiez que son offre correspond à vos attentes et à vos règles de gouvernance, et vous vous appuyez sur le contrat que vous avez signé avec lui.
Pourquoi le SaaS reste à l’extérieur
Le SaaS est le troisième type d’application et celui que l’on oublie le plus facilement. Ces applications bénéficient souvent d’une porte ouverte sur notre système d’information via l’authentification unique, le provisioning automatisé et tous les autres échanges de données que nous acceptons, ce qui leur permet de collecter des données de l’entreprise et de les exploiter plus tard. Nous les gardons hors de cette porte d’entrée pour trois raisons : elles ne sont pas hébergées par l’IT de l’entreprise, l’IT n’a pas accès à leur code, et une souscription implique des obligations contractuelles de la part de l'éditeur/hébergeur : le fournisseur est responsable de l’hébergement, mais aussi de la sécurité et de la conformité de sa solution. Elles méritent leur propre réponse, par des contrats et des revues d’échange de données plutôt que par des pipelines.
Une application, un projet
Une application = un projet dédié (du point de vue de l’hébergement du code et de l’infrastructure sous-jacente). Jamais deux dans un seul, jamais une répartie sur plusieurs.
Cette règle unique gènère beaucoup de travail. Les accès, la responsabilité, la traçabilité et les coûts en découlent dès lors qu’une application a une infrastructure qui lui appartient en propre. De plus, chaque application doit avoir a un responsable métier et un responsable technique nommés. Les responsabilités de ces personnes doivent par ailleurs clairement être explicitées en amont car elles ont un rôle essentiel à jouer dans la gestion du cycle de vie des applications.
Ce dont une nouvelle application a vraiment besoin
Avant son premier déploiement, même une petite application demande une quantité surprenante d'actions. Chaque élément est simple en soi ; ensemble, ils font la différence entre un prototype et une application en production. Avant de parler d’hébergement à l’échelle de l’entreprise, voici le socle que toute application doit démontrer et respecter :
- Une identité et un responsable. Qui peut y accéder, qui en répond, qui est prévenu quand quelque chose tombe en panne.
- Un endroit ou stocker le code, avec historique, revue et branches protégées.
- Une manière standardisée d’être construite, toujours de la même manière, avec des contrôles à chaque étape.
- Un endroit où être exécutée, avec sa propre adresse, des secrets tenus hors du code et des accès au moindre privilège.
- Une manière d’être monitorée, pour que les bonnes personnes apprennent un problème avant les utilisateurs.
- De nombreuses exigences en termes de sécurité, l’infrastructure sous-jacente doit être déployée conformément au concept de sécurité de l’entreprise.
- Beaucoup de gouvernance, chaque composant déployé pour les points ci-dessus doit respecter les standards, afin que les utilisateurs ne puissent pas faire plus que ce qu’ils ont demandé et dont ils ont besoin, ce qui pourrait introduire des failles de sécurité et rendre les coûts incontrôlables.
Une règle dans un document finit systématiquement par être contournée
Une règle qui vit dans un document est faite pour être contournée. Une règle qui vit dans l’automatisation est forcément suivie.
On ne peut pas compter sur les humains pour respecter des consignes, encore moins lorsqu’elles sont écrites. Elles ne sont jamais lues. C’est encore plus vrai avec le vibe coding, où les personnes qui construisent n’ont le plus souvent pas les connaissances requises pour construire et mettre en production leurs applications. Cela impose une exigence forte : le processus de construction de bout en bout doit être encadré par des garde-fous et automatisé, ce qui implique à son tour des architectures standardisées.
Chaque étape a donc dû passer un test : une machine peut-elle l’appliquer ? Les règles sont devenues des contrôles qui s’exécutent à chaque changement, dans le même ordre, avec le même résultat pour tous.
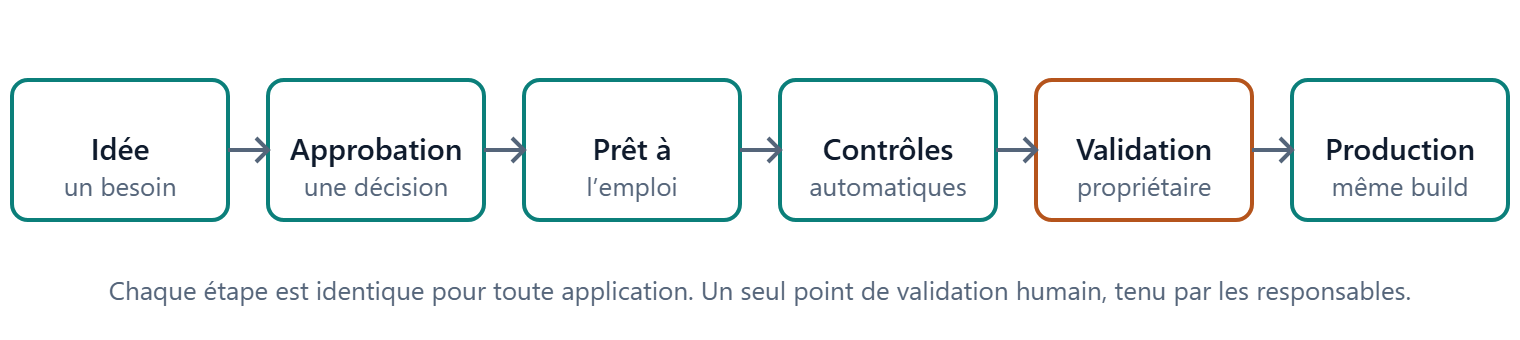
- Des contrôles de qualité, de sécurité et de vulnérabilités avant toute construction. Un code qui ne les a pas passés ne devient jamais un package. La liste des contrôle reste est ouverte by design : de nouveaux contrôles, comme la preuve que la documentation a été mise à jour avec le changement, peuvent être ajoutés une fois et s’appliquer à toutes les applications déjà déjà onboardées ainsi qu'à venir.
- La livraison est idempotente : la version testée est la version livrée. Le package exact qui a été testé est celui qui est promu à l’étape suivante, jamais il n'y a de reconstruction qui lui serait seulement approchant. Exécutez deux fois le même déploiement et vous obtenez le même résultat, ce qui rend chaque mise en production reproductible et explicable.
- Les responsables d’application et les responsables métier décident, et en ont les moyens. Les personnes qui répondent d’une application approuvent sa mise en production après une vraie recette ; ceux qui écrivent le code ne se valident pas eux-mêmes. L’objectif est, après que la nouvelle version de l'application viennent d'être envoyée en production, la fin du fameux « nous avons un P1, l’application ne fonctionne plus », qui, dans la pratique, vient presque toujours d’une recette utilisateur jamais correctement réalisée.
- Chaque mise en production est vérifiée, et les bonnes personnes sont mobilisées immédiatement. Une batterie de tests s’exécute à chaque étape pour confirmer que rien n’a été cassé, suivie d’une supervision approfondie de la mise en production et d’alertes, afin que le responsable soit appelé dès que nécessaire, et non quand les utilisateurs se plaignent.
Le provisioning sans attente
Obtenir l'environnement, l'infrastructure pour une nouvelle application signifiait autrefois des dizaines de demandes à plusieurs d’équipes distinctes, chacune avec son formulaire, son délai et sa propre interprétation des règles. Nous l’avons remplacé par une courte série de procédures automatisées, bâties sur une architecture très standardisée mais néanmoins flexible. Chacune a son propre rôle, et chacune est exécutée par l’équipe de gestion de la plateforme applicative, en quelques minutes plutôt qu’en quelques semaines :
- Identités et accès. Les groupes qui définissent qui peut développer, approuver, administrer et accéder à cette application, et les identités propres à l’application, créés avec leurs responsables nommés et vérifiés.
- Un dépôt pour y stocker le code. Un projet de livraison dédié avec son dépôt, une branche principale protégée, une revue obligatoire, et la règle que rien n’y arrive sans avoir passé les contrôles.
- Le runtime. Un ensemble de ressources standardisées respectant les règles d egouvernance, les containers pour chaque composant de l’application et, si elle en a besoin, sa base de données, accessible uniquement depuis le réseau privé.
- Les pipelines de livraison. Build, test, mise en production sur l’environnement de recette, mise en production, chacun relié aux règles partagées et aux points de validation détenus par les responsables d’application et les responsables métier. Tous ces pipelines sont gérés par l’équipe de gestion de la plateforme applicative.
- Des permissions au moindre privilège. Chaque pipeline et chaque conteneur reçoit exactement l’accès dont il a besoin, et rien de plus : récupérer sa propre image, lire ses propres secrets, déployer sur son propre environnement.
- La publication de l’application. Le nom enregistré (enregistrement de domaine), le certificat public, et le point d’entrée qui publie l’application auprès de ses utilisateurs, toujours via les équiepements contrôlés, qui assurent la sécurité en même temps.
La sortie de chaque étape alimente la suivante. Le nom de l’application, sa lane et sa structure sont saisis une seule fois et propagés, de sorte que la personne qui effectue le provisioning confirme au lieu de ressaisir, tout en pouvant modifier n’importe lequel des choix proposés. Ce qui était une file de tickets devient une seule session guidée, et le résultat est identique pour chaque application : même nommage, mêmes garde-fous, même organisation.
Chaque procédure de provisionning de l'environnement respecte le même contrat :
- Aperçu d’abord. Elle montre son plan complet d'exécution avant de modifier quoi que ce soit, afin que l’équipe de gestion de la plateforme applicative puisse repérer tout écart par rapport aux standards et l’adapter avant que les systèmes ne soient modifiés.
- Sans risque à répéter. Une seconde exécution ne se fera jamais et n’écrase jamais ce qui existe déjà, ce qui permet à l’équipe plateforme d’identifier rapidement les adaptations qui pourraient être nécessaires.
- Des preuves, pas des promesses. Chaque exécution laisse une trace de preuve, sans aucun secret, qu’un auditeur peut lire des mois plus tard.
Ainsi, l’environnement est provisionné de bout en bout en quelques minutes, de façon entièrement standardisée : chaque application bénéficie de la même plateforme sous-jacente que ses consœurs.
Les pipelines sont le seul moyen de construire une application, et ils appartiennent à la plateforme
Aucune application n’est jamais construite ni livrée à la main.
L’ensemble du processus de construction et de contrôle repose sur des pipelines qui restent sous l’autorité des responsables de la plateforme applicative. Personne d’autre ne peut les modifier, et aucune modification n’entre en vigueur sans leur approbation et leur confirmation. Les développeurs utilisent les pipelines et peuvent demander des adaptations s'ils en ont besoin. En revanche, ils ne peuvent jamais les modifier.
Tout est déclenché par des événements : un changement soumis, un changement accepté, une mise en production approuvée. Les mêmes pipelines s’exécutent à chaque fois, et c’est ce qui rend les contrôles dignes de confiance.
Cela change aussi qui peut construire. Des personnes sans compétences en développement ou en infrastructure (les vibe coders) peuvent tout de même créer leurs applications, parce que la plateforme porte la charge de les construire, les sécuriser, les héberger et les livrer. Ainsi, elles répondent aux attentes de l’entreprise par construction, et non par expertise.
Corriger une fois, corriger partout
Quand les applications se multiplient, un risque discret grandit : la logique de livraison. Elle est copiée dans chaque projet et chaque copie copie pourrait dériver. Un correctif aurait alors besoin de se propager vers des dizaines d’endroits, avec le risque qu'il n’atteignent jamais certains. Notre réponse est de détenir les règles de livraison une seule fois, en un lieu que les équipes applicatives peuvent utiliser mais pas modifier. Ce qu’une application dit d’elle-même, combien de composants elle comporte et comment les construire, tient dans un petit fichier de configuration que l'équipe en charge de l'application détient. Tout le reste est partagé.
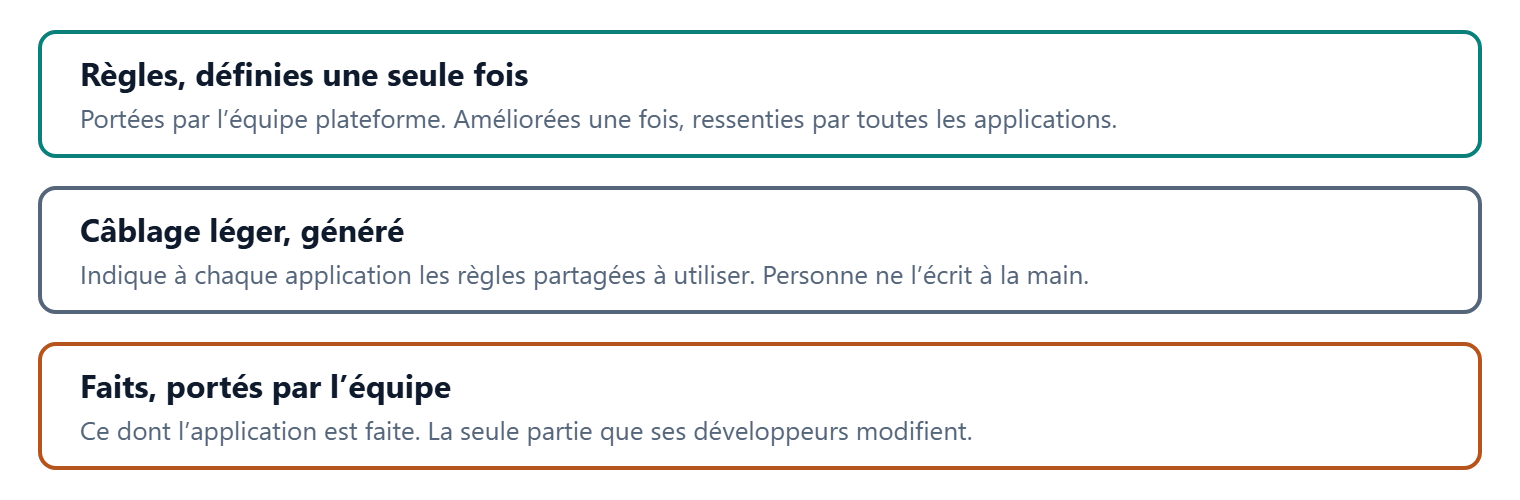
Une application peut être un seul service ou une petite famille de services, publiée sur le web ou tournant discrètement en arrière-plan. La plateforme s’adapte au lieu de demander des exceptions, et une modification d’une règle est d’abord essayée sur une application de test, puis atteint toutes les autres applications en même temps.
Des standards, pas de dépendance
L’architecture sous-jacente est délibérément standardisée. Les applications sont packagées sous forme d'images conteneurs standards (les formats ouverts OCI et Docker), et tout ce qui les entoure est conçu pour traiter ce package comme une unité de livraison. La conséquence est la portabilité : la même démarche peut migrer vers n’importe quel hébergeur, plateforme ou technologie qui respecte ces standards. Nous standardisons l’architecture, pas le fournisseur.
Les leçons du terrain
Nous n’avons pas conçu cela uniquement sur un tableau blanc. Nous l’avons éprouvé sur un environnement réel, et avons pu entirer les enseignements suivants :
- Planifiez en fonction de ce que la sécurité autorisera réellement, pas en vous basant exclusivement sur ce que montre le tutoriel. Par exemple, de nombreuses organisations bloquent les moyens de connexion rapides au travers de scripts.
- Moins de dépendances valent mieux que des dépendances ingénieuses. Plusieurs versions du même outillage côte à côte peuvent casser un script qui fonctionnait hier.
- Un aperçu qui saute la moitié des contrôles est un faux réconfort. L’aperçu et l’exécution réelle doivent aboutir aux mêmes état et conclusions.
- Soyez honnêtes sur ce qui est prouvé. Nous indiquons et consignons exactement ce qui a été exécuté et ce qui ne l’a pas été. Cela inspire plus de confiance qu'un output synthétique et partiel.
Où nous en sommes aujourd’hui
Le standard pour les deux lanes est défini. L’automatisation complète, du provisioning aux pipelines qui construisent et livrent chaque application, est construite. Nous passons du banc de conception aux premiers déploiements réels, avec une application de test dédiée qui valide chaque nouvelle brique avant qu’on lui fasse confiance ainsi que le déploiement des premières infrastrutures à des fins de production. L’ambition à plus long terme est une porte d’entrée unique où les équipes trouvent les consignes, consultent le détail de leur propre application et reçoivent tout ce dont elles ont besoin une fois leur environnement prêt. Nous étudierons aussi une flexibilité accrue, afin que les applications les plus légères, comme les applications non web ou les scripts, puissent être intégrées à ce modèle comme une application Lane B standard. La gestion du cycle de vie et des analyses de sécurité régulières et automatisées (et des réponses associées) feront également partie du tableau.
Qui est derrière cette démarche?
Cette démarche n’a pas été mise au point par un développeur logiciel. Elle vient d’un ingénieur avec un background d'architecture cloud, infrastructure et sécurité. C’est pourquoi elle part de questions qu’un développeur se pose rarement en premier : qui a le droit de faire cela, qu’est-ce qui peut mal tourner, que voudra voir l’auditeur, et que se passe-t-il quand la personne qui l’a construit s’en va ? Quand tout le monde peut produire du code, la compétence rare est de décider ce que le code a le droit de faire, où il peut tourner et qui en répond.
Envie de voir comment cela s’intégrerait dans votre organisation ? Contactez-nous pour un échange ou une démonstration.